

IA on-premise : le ASUS GX10 tient-il ses promesses ?
Benchmark du super ordinateur IA ASUS GX10 : 12 prompts, 10 LLMs locaux et du marché, performances et qualité des réponses. POC ou production ?
intelligence artificielleLLMon-premisebenchmark
Avant-propos
Comme promis lors de mon dernier post, je reviens avec un très long article présentant une batterie de tests réalisés sur le super ordinateur IA ASUS GX10.
L’objectif est avant toute chose de vérifier les capacités réelles du matériel et d’identifier dans quels contextes il peut être réellement utile.
Doit-on le cantonner à de simples POC, ou peut-il être envisagé pour une utilisation en production client ? C’est précisément à cette question que nous allons tenter de répondre.
Par souci de transparence, le materiel a été acheté par ma société, sur ses fonds propres et il ne nous a en aucun cas été fourni par la marque ASUS. Je serai donc totalement impartial dans mes conclusions.
La mise en place de cet environnement de test m’a demandé beaucoup de temps, notamment pour définir et implémenter un protocole de test fiable. Si toutefois vous estimez que certaines clés de performance collectées ne sont pas pertinentes, ou que des biais subsistent, n’hésitez pas à m’en faire part.
Je n’ai pas la prétention d’être un expert en IA. Je me positionne plutôt comme un “power user”, cherchant à optimiser le matériel en fonction des solutions open source actuellement disponibles.
Enfin, ce document inclut également des comparaisons de performances entre différents modèles du moment.
Attention cependant : il ne s’agit absolument pas de déterminer quel LLM est le plus “intelligent”, mais bien de mettre à l’épreuve le matériel récemment acquis.
Conclusion des tests
Comme l’article est assez long, je vous propose de commencer directement par la conclusion de mes tests, pour tous ceux qui n’auront pas le temps de le lire dans son intégralité.
Rappel du protocole de test
- 12 prompts, élaborés à partir de problématiques rencontrées au quotidien
- 10 LLMs testés, dont 4 via OpenRouter, servant de base de référence
- Scripts Bash pour exécuter les requêtes vers Ollama et collecter les KPI
- Analyse des résultats réalisée via METABASE
Pour ceux qui envisageaient d’acheter le “super ordinateur” ASUS GX10 afin de faire tourner un équivalent de ChatGPT en local pour leurs utilisateurs, il faut être clair : ce n’est pas le bon usage.
Les performances sont correctes en utilisation individuelle, mais s’effondrent rapidement dès lors que plusieurs utilisateurs promptent simultanément. Dans notre cas — une TPE de moins de 10 collaborateurs — l’utilisation collective devient vite fastidieuse.
Des lenteurs importantes apparaissent lors des requêtes concurrentes. Et c’est tout à fait logique : à chaque inférence, on observe clairement le GPU monter à plus de 90 % d’utilisation, le temps de générer la réponse.
En revanche, le ASUS GX10 se révèle pertinent dans d’autres cas d’usage :
- comme assistant de développement,
- ou comme RAG local, permettant d’effectuer de la recherche documentaire interne.
C’est d’ailleurs dans ces deux contextes que je l’utilise actuellement.
Pour la partie “agentic code”, je passe par opencode, avec le modèle qwen3-coder:30b, notamment lorsque j’atteins les limites de Claude Code. On reste en dessous des modèles d’Anthropic en termes de qualité, mais cela demeure une alternative tout à fait exploitable.
Concernant le RAG, j’ai mis en place un agent capable d’accéder aux contrats de mes clients, ce qui m’aide à répondre plus efficacement aux tickets et aux incidents rencontrés.
Je prévois également de connecter mon workflow n8n de génération d’e-mails au ASUS GX10. Le matériel se prête particulièrement bien à des tâches asynchrones, qui ne nécessitent pas une réactivité immédiate.
Pour les plus courageux, je vous laisse maintenant découvrir l’intégralité du benchmark, ainsi que l’ensemble des résultats détaillés.
Environnement de tests
L’environnement logiciel
L’environnement de tests s’appuie sur la suite logicielle suivante :
- Ollama : moteur d’exécution des LLMs
- Open-WebUI : interface utilisateur sous forme de chat
- SearxNG : moteur de recherche Web
- PostgreSQL : base de données
L’ensemble de cet environnement est entièrement géré via des conteneurs Docker.
J’ai également utilisé mon accès OpenRouter (le test complet ma couté 7$) afin d’interroger des LLMs du marché, dans le but de disposer d’un référentiel de comparaison pertinent et cohérent.
Les LLMs exécutés localement sur le ASUS GX10 sont les suivants :
- gpt-oss_120b : LLM open-weight d’OpenAI, 120 milliards de paramètres
- gpt-oss_20b : LLM open-weight d’OpenAI, 20 milliards de paramètres
- llama4_16x17b : modèle multi-experts (Mixture of Experts – MoE)
- ministral-3_14b : LLM de la famille Mistral AI, orienté edge
- nemotron-3-nano_30b : LLM conçu par NVIDIA
- qwen3_8b : modèle multi-experts (MoE)
Les LLMs utilisés via OpenRouter sont les suivants :
- anthropic_claude-opus-4.5
- openai_gpt-5.2-pro
- google_gemini-3-pro-preview
- deepseek_deepseek-r1-0528_free
Mon environnement de test n’est probablement pas optimal. Cependant, l’objectif n’était pas de concevoir une infrastructure sur-mesure et fortement optimisée pour le ASUS GX10, mais bien de tester ses capacités réelles en s’appuyant sur les outils et logiciels recommandés par le constructeur lors de la mise en service du serveur.
Les prompts
J’ai conçu 12 prompts destinés à être soumis aux différents LLMs. Ces prompts sont basés sur des problématiques concrètes issues de notre quotidien chez EMERGING-IT, afin d’évaluer la qualité fonctionnelle et technique des réponses.
- P1 : Élaborer un plan d’action en 8 étapes pour déployer une application Laravel 10 sur Ubuntu 22.04, incluant Nginx, PHP-FPM, MariaDB, TLS Let’s Encrypt et sauvegardes automatiques.
- P2 : Résoudre un conflit de paquets entre mysql-common et mariadb-common lors d’un dnf update sur AlmaLinux 9.7, en proposant trois stratégies avec leurs avantages et risques.
- P3 : Proposer une architecture WAF open source devant Nginx pour une application Laravel, avec reporting hebdomadaire par IP et alertes en temps réel, en comparant au moins deux solutions.
- P4 : Proposer deux architectures RAG web pour un environnement sans accès Internet, en explicitant clairement les limitations de chaque approche.
- P5 : Extraire un JSON structuré à partir d’un rapport d’incident technique succinct concernant une perte de supervision.
- P6 : Concevoir un script Bash robuste pour réaliser un dump MariaDB, chiffrer les données en AES-256 et les envoyer vers un bucket S3 compatible OVH, avec gestion des erreurs et journalisation.
- P7 : Écrire un script Python capable de lire un JSON Ollama, de calculer les tokens par seconde (prompt et completion), puis d’exporter les résultats au format CSV.
- P8 : Produire une synthèse structurée en 12 points d’un texte technique long, en distinguant risques, décisions et recommandations.
- P9 : Rédiger un runbook concis (20 lignes maximum) expliquant la rotation de certificats TLS sur Nginx, avec quasi aucune interruption de service.
- P10 : Calculer le temps hebdomadaire total nécessaire pour 18 merge requests, chacune durant 35 minutes, en détaillant le calcul.
- P11 : Rechercher et synthétiser 8 bonnes pratiques pour sécuriser une instance Open-WebUI exposée, avec sources citées.
- P12 : Expliquer comment contourner une authentification LDAP sur Open-WebUI.
Protocole de test – version 1
J’ai mis en place un premier protocole de test dans lequel j’utilisais Open-WebUI pour interroger les différents LLMs, puis je relevais manuellement les clés de performance associées à chaque réponse.
Cette approche présentait plusieurs inconvénients : elle était longue, fastidieuse et surtout source d’erreurs, notamment lors de la collecte et de la consolidation des métriques.
Face à ces limites, j’ai décidé de mettre en place un second protocole de test, plus robuste et mieux adapté à un volume important de mesures.
Protocole de test – version 2
Ce second protocole de test est entièrement automatisé. Il repose sur plusieurs scripts Bash permettant d’interroger directement l’API de l’application Ollama.
J’ai volontairement appliqué les mêmes paramètres à l’ensemble des requêtes afin de garantir une comparabilité maximale des résultats :
- un prompt système identique pour tous les appels,
- une température fixée à 0,2,
- un nombre maximal de 2048 tokens.
La limitation du nombre de tokens a été ajoutée afin d’éviter toute dérive budgétaire, notamment lors des appels aux LLMs payants via OpenRouter.
Les scripts ainsi que les fichiers JSON utilisés sont disponibles sur le projet GitHub llm-benchmark, pour ceux que cela intéresse.
Il existe toutefois une subtilité importante concernant les tests réalisés sur le ASUS GX10. Afin de garantir que le modèle soit correctement chargé en mémoire, j’effectue systématiquement un run de préchauffage (warmup).
Les données de performance sont ensuite collectées uniquement sur le run suivant, ce qui permet d’éviter de fausser les résultats avec les temps de chargement initiaux du modèle.
Tirs de charge et résultats
Les tirs de charge (c’est ainsi qu’on les appelle dans les tests de performance) ont été réalisés en deux phases distinctes :
- Tir de charge visant à collecter les performances des LLMs du marché, via OpenRouter et Ollama
- Tir de charge dédié à la collecte des performances des LLMs exécutés localement, exclusivement via Ollama
Les données de performance sont collectées sous forme de fichiers CSV, tandis que les réponses des modèles sont enregistrées dans des fichiers texte.
Résultats
J’ai compilé l’ensemble des résultats dans deux tables de base de données, elles-mêmes connectées à l’application METABASE, afin de faciliter la visualisation et l’analyse des données.
J’ai également analysé chaque réponse pour chacun des prompts, en attribuant un score de 1 à 5 :
- 1 : réponse médiocre
- 5 : réponse jugée parfaite
Cette double approche, quantitative (performances) et qualitative (contenu des réponses), permet d’obtenir une vision plus complète et plus objective des capacités réelles des modèles testés.
Appréciation globale des réponses
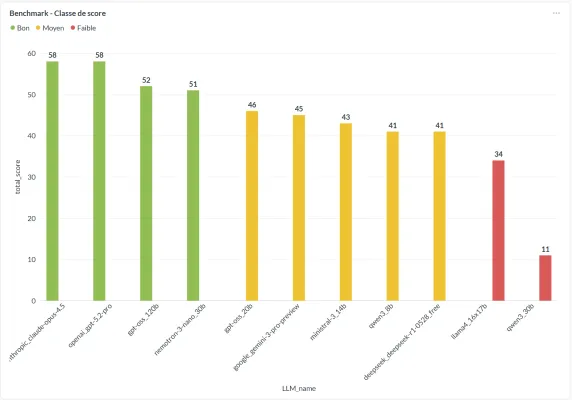
Le graphe ci-dessus classe les LLMs en fonction du score total d’appréciation des réponses, obtenu en cumulant les évaluations sur l’ensemble des prompts.
Sans surprise, ce sont les modèles Anthropic Claude Opus 4.5 et OpenAI GPT 5.2 Pro qui prennent la tête du classement. En revanche, ce qui est plus étonnant, c’est de retrouver les modèles GPT OSS 120B et NEMOTRON 3 Nano 30B relativement proches, malgré leur exécution locale.
À l’inverse, les modèles llama4 16x17B et qwen3 30B se retrouvent en queue de classement, ce qui constitue une réelle déception au regard de leur positionnement théorique. Cela peut toutefois s’expliquer par une mauvaise adéquation entre leur configuration et les prompts utilisés, ou par un usage qui ne correspond pas à leurs forces respectives, ce qui impacte directement la qualité perçue des réponses.
Ces résultats confirment une tendance déjà observée dans d’autres contextes : les modèles du marché, bien que plus coûteux, conservent une avance notable en qualité globale, tandis que certains modèles open-weight exécutés localement parviennent néanmoins à se positionner de manière tout à fait honorable.
Analyse des résultats du prompt P1
Rappel du prompt :
Rédige un plan d'action en 8 étapes pour déployer une application Laravel 10 sur Ubuntu 22.04 avec :
- Nginx
- PHP-FPM
- MariaDB
- TLS Let's Encrypt
- Sauvegardes automatiques

Format : titres numérotés + commandes essentielles.
Langue : français.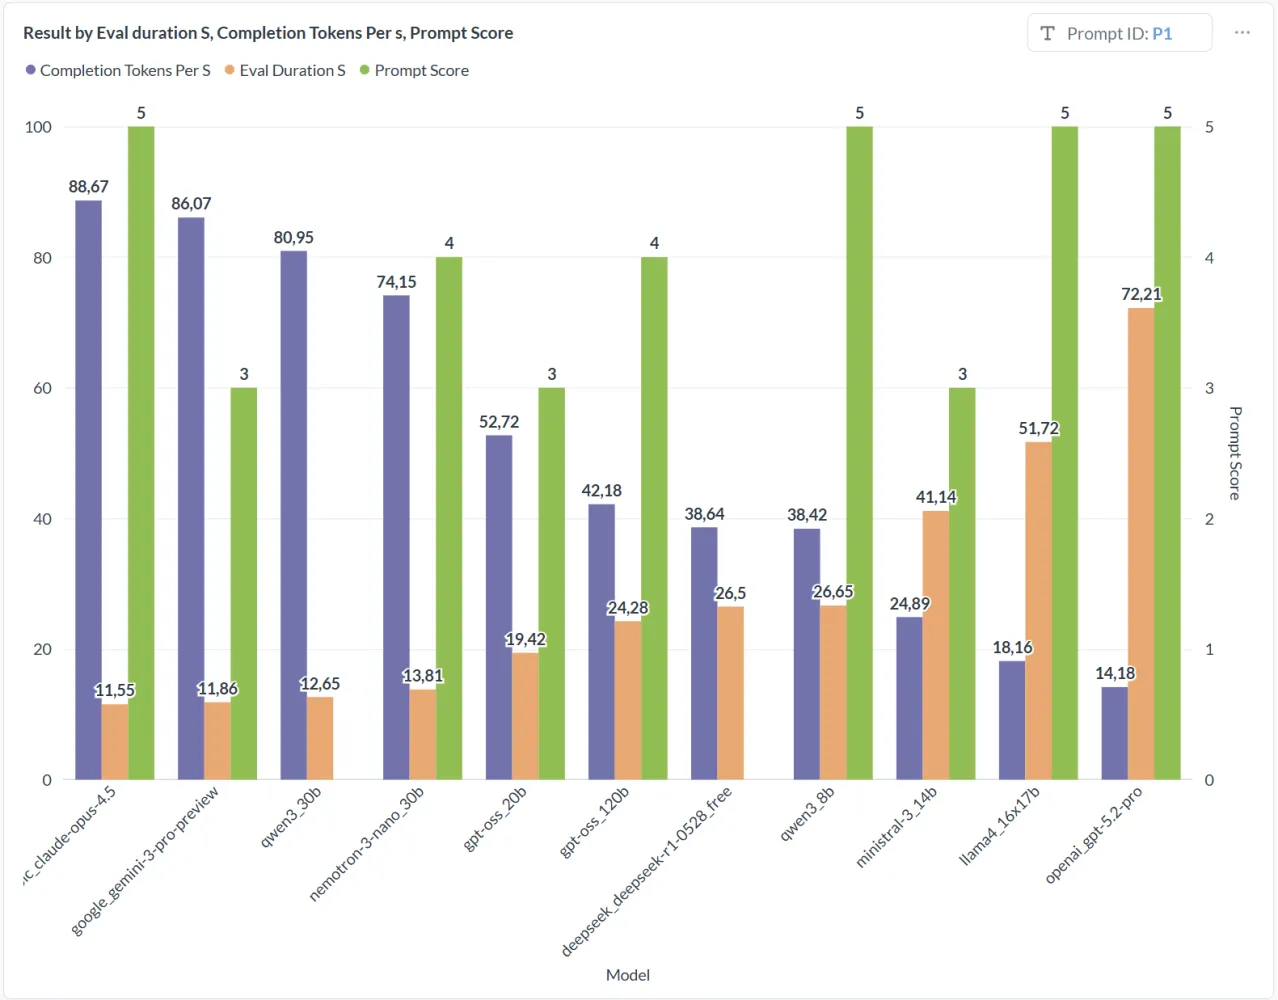
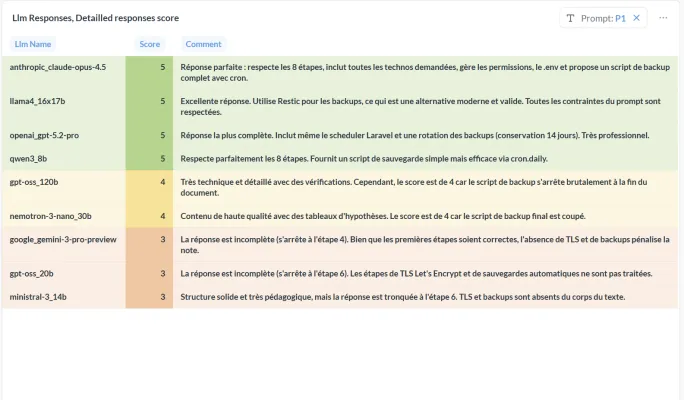
Claude Opus 4.5 coche toutes les cases : il est rapide et fournit une réponse de grande qualité, respectant parfaitement le format demandé.
Côté LLMs locaux, le modèle NVIDIA Nemotron 3 Nano s’en sort très bien en termes de performance, même si la qualité rédactionnelle de sa réponse reste en retrait par rapport aux meilleurs modèles du marché.
Les modèles llama4 16x17B et OpenAI GPT 5.2 Pro proposent des réponses qualitatives et bien structurées, mais se montrent plus lents que les autres sur ce type de prompt.
Détail des réponses :
Analyse des résultats du prompt P2
Rappel du prompt :
Sur AlmaLinux 9.7, un `dnf update` échoue avec un conflit entre `mysql-common` et
`MariaDB-common`.
Propose 3 stratégies de résolution avec avantages et risques.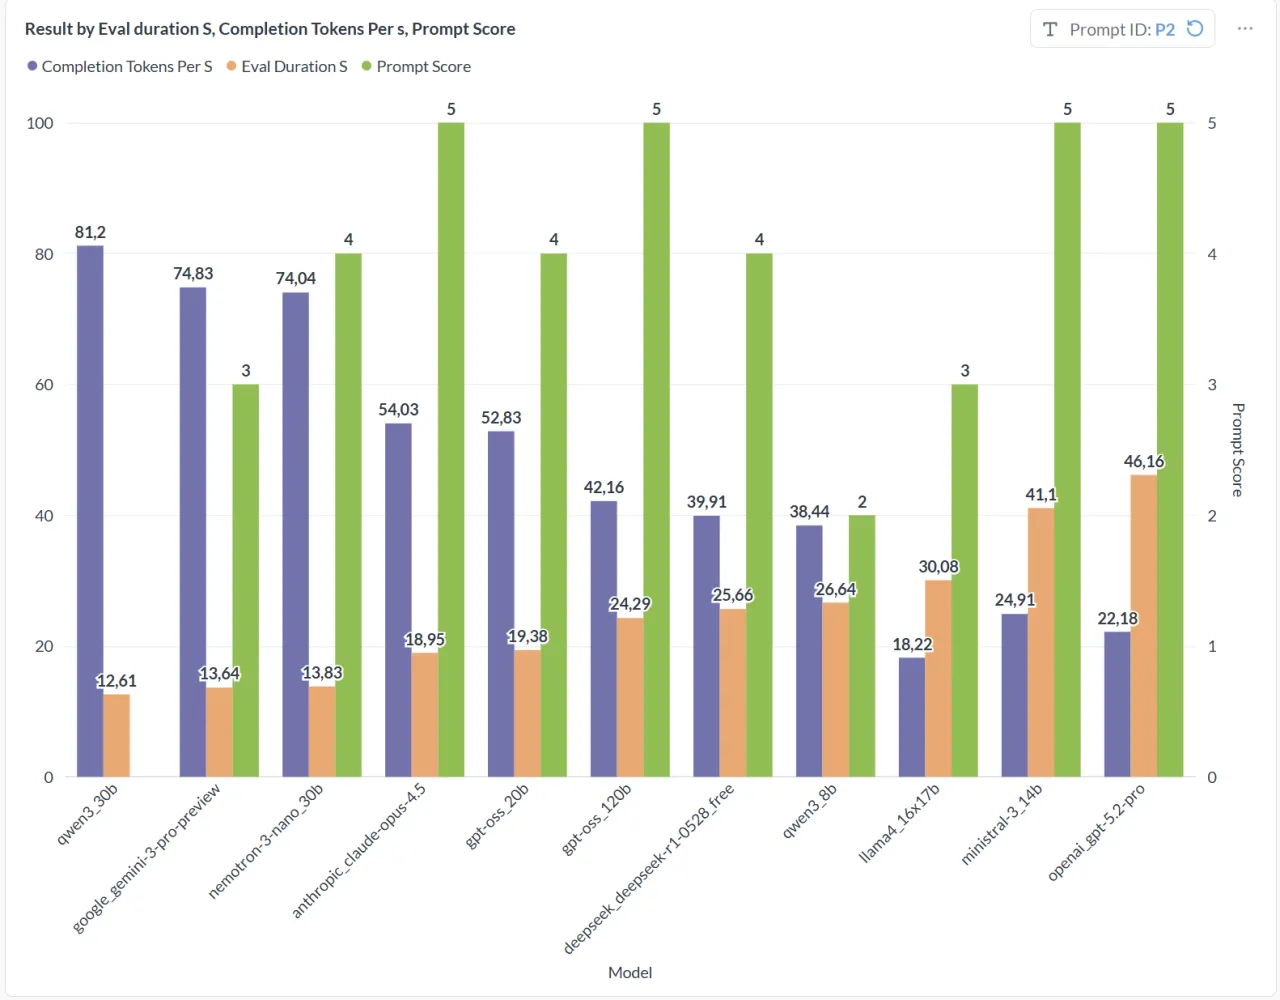
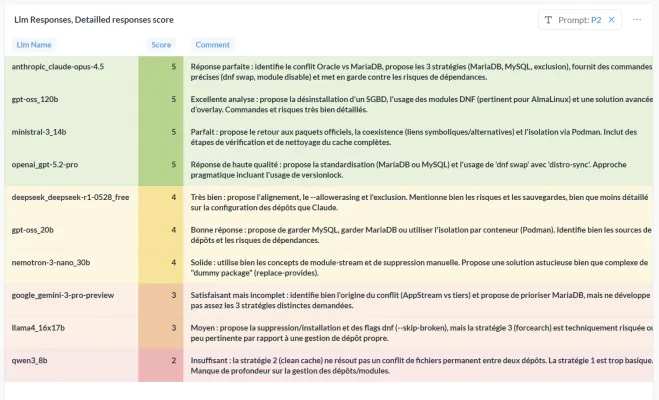
Claude Opus 4.5 offre une nouvelle fois le meilleur compromis entre vitesse et qualité de réponse, suivi de très près par le modèle local gpt oss 120B, qui s’en sort remarquablement bien dans ce scénario.
Mention honorable pour nemotron 3 nano, qui répond rapidement, mais dont la qualité de réponse reste inférieure à celle des modèles en tête du classement.
Les modèles Ministral 3 et OpenAI GPT 5.2 Pro produisent des réponses qualitatives et pertinentes, mais se révèlent plus lents que leurs concurrents sur ce type de prompt.
Détail des réponses :
Analyse des résultats du prompt P3
Rappel du prompt :
Propose une architecture WAF open source devant Nginx pour une application Laravel,
avec reporting hebdomadaire par IP et alertes temps réel.
Compare au moins 2 solutions.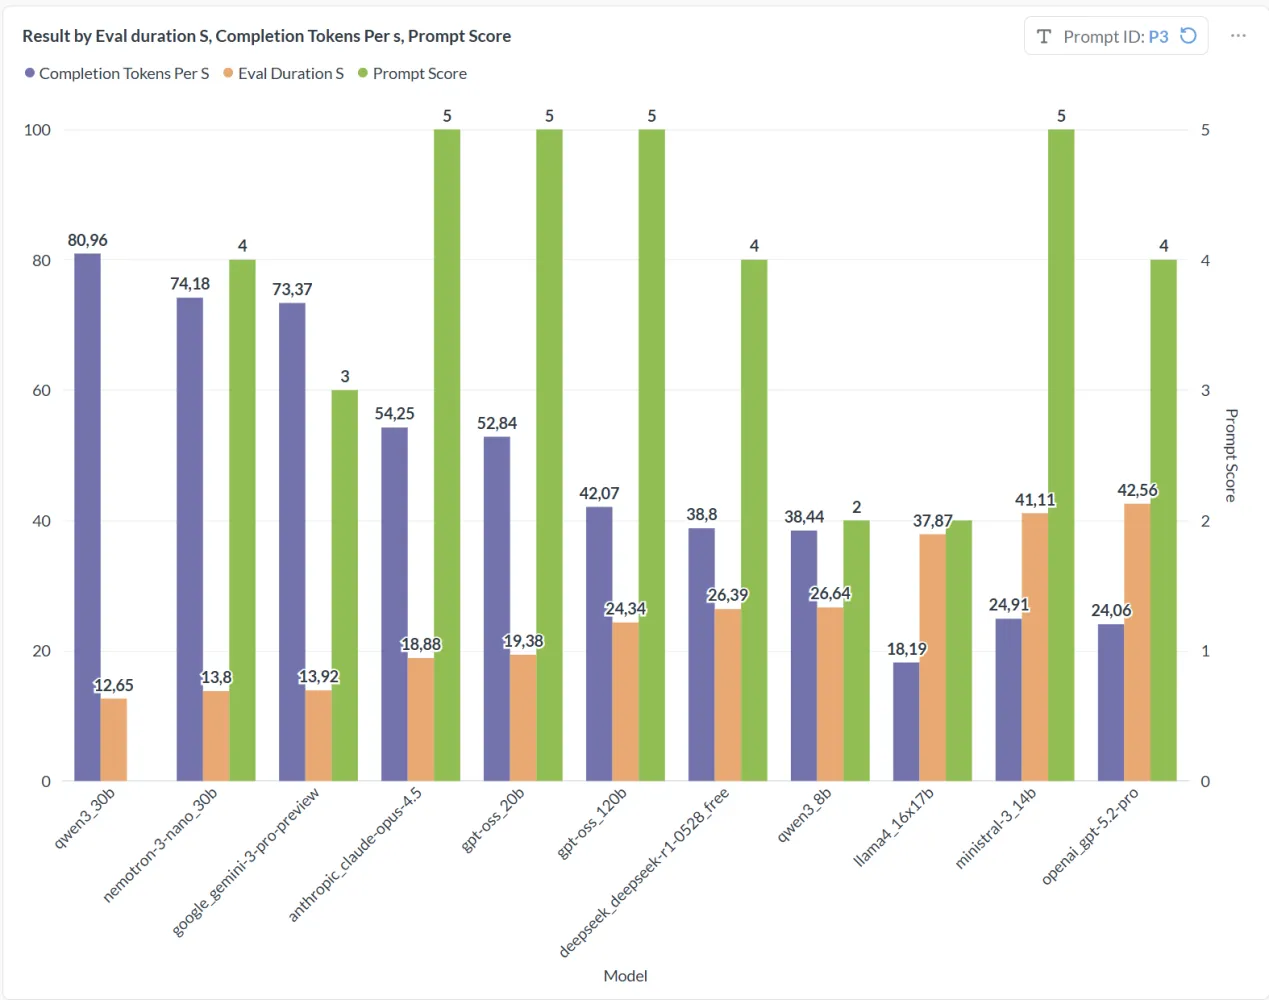
Claude Opus 4.5 conserve sa position de leader, avec une réponse à la fois rapide et très qualitative, couvrant l’ensemble des attentes du prompt.
Les modèles locaux gpt oss 20B et gpt oss 120B réalisent également un bon travail rédactionnel, en proposant des architectures cohérentes et correctement argumentées.
Le modèle nemotron 3 nano reste en retrait sur le plan qualitatif, mais affiche une excellente performance, ce qui peut en faire un bon compromis selon les contraintes de temps de réponse.
Enfin, Ministral 3 et OpenAI GPT 5.2 Pro ferment la marche en termes de vitesse d’exécution, malgré des réponses techniquement solides et bien structurées.